所有读数都正常
进程活着、心跳新鲜、日志干净、耗时正常——而它两个多小时没干活。后台服务死了八天没人知道,一条指令挂了八小时二十七分还串进了下一条。这些故障都不报错,护栏就是这么一根一根加上去的。这是连载的第三篇。
上一篇讲的是这套东西怎么运转起来的。这一篇讲它掉链子。
我原本以为,出问题就是出问题——报个错,弹个窗,或者干脆罢工。真上手了才发现,最难对付的不是这种。最难对付的是:它坏了,但它不说。
进程活着,日志在长,状态灯是绿的,从外面看它一直在跑。只有我发过去一句话石沉大海,才知道它早就不干活了。
01 看守自己死了,八天没人知道
先说最丢人的一件。
我给几个后台服务各配了一个「看守」——专门盯着它有没有死、死了就重启。有天我心血来潮清点本机上自己写的常驻服务,一共十五个。顺手看了看三个看守的状态:
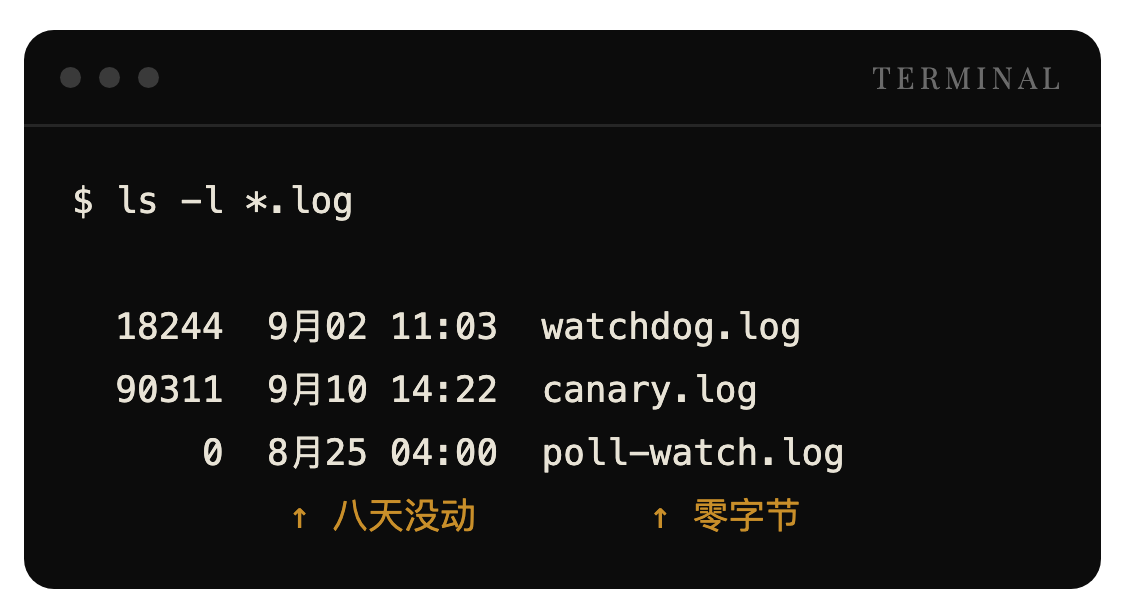
一个停了八天。另一个更离谱——日志零字节,它从来没写出过一个字节,也就是说它很可能从装上那天起就没真跑过。
人话:我雇了三个保安看守大门,其中两个在岗亭里躺了小半个月,而我一直以为大门有人看着。保安没有保安。
更难看的是那十五个服务的构成。九个在伺候三条聊天通道——通道本身、通道的看守、探活的探子。真正服务于我每天要做的正经事的,只有四个。
九比四。而那三条聊天通道,一条都不在我列出的正经事里面。
通道是为了方便我派活,看守是为了看住通道,探子是为了看住看守。我养了一群互相看守的东西,它们唯一的产出就是彼此。
后来做了一轮减法:
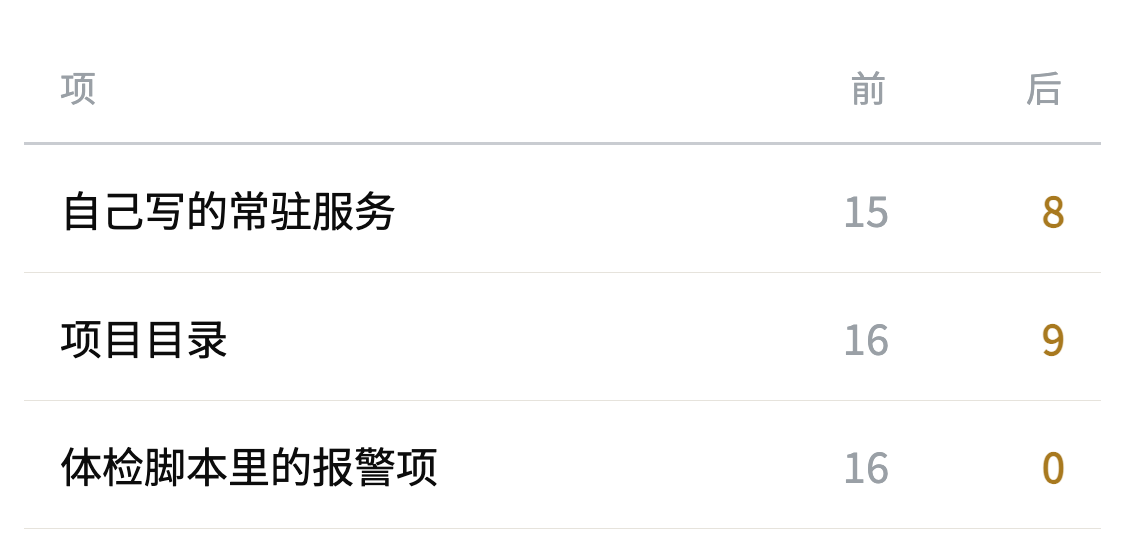
最后一行值得多说一句。那十六项报警,是长期挂在那儿的假警报——我早知道它们是误报,看见了就跳过。删干净之后,底下露出两个真问题,一直被埋着。
告警里长期挂着一批已知的假阳性,等于把真阳性也一起埋了。
02 两小时二十分,日志一行没有
那天下午,我在外面发消息回家,没反应。再发,还是没反应。
回去一看,现场是这样的:
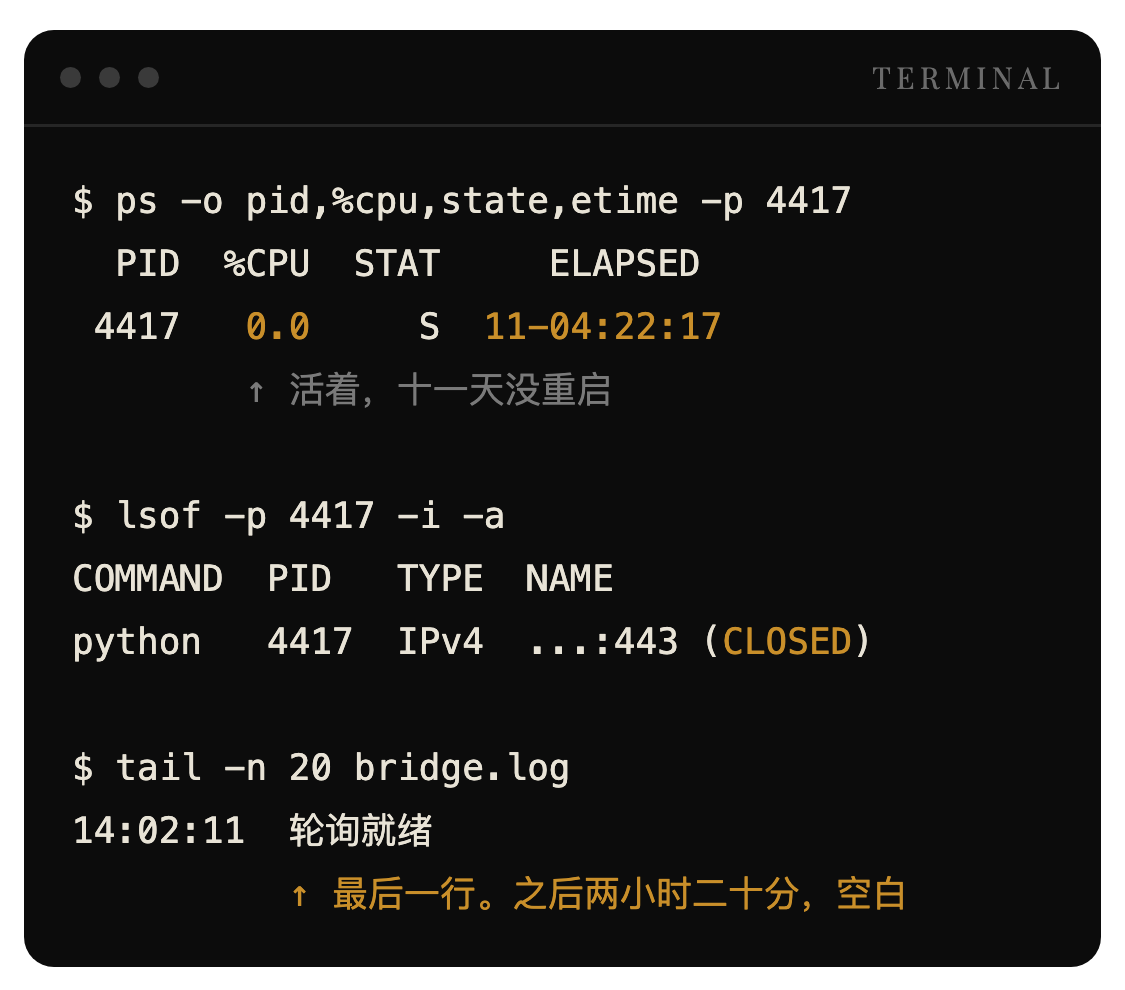
四个特征凑在一起,怎么看都像个健康的进程在待命。它不是。它在原地空转了两小时二十分。
根子在一个我完全没想到的地方。
我用的那个收发消息的库,内部有个重试循环:出错了就等一会儿再试,同时把错误记进日志。但它对「超时」这一类错误开了个特殊分支,既不记日志,也不等。大意是这样:
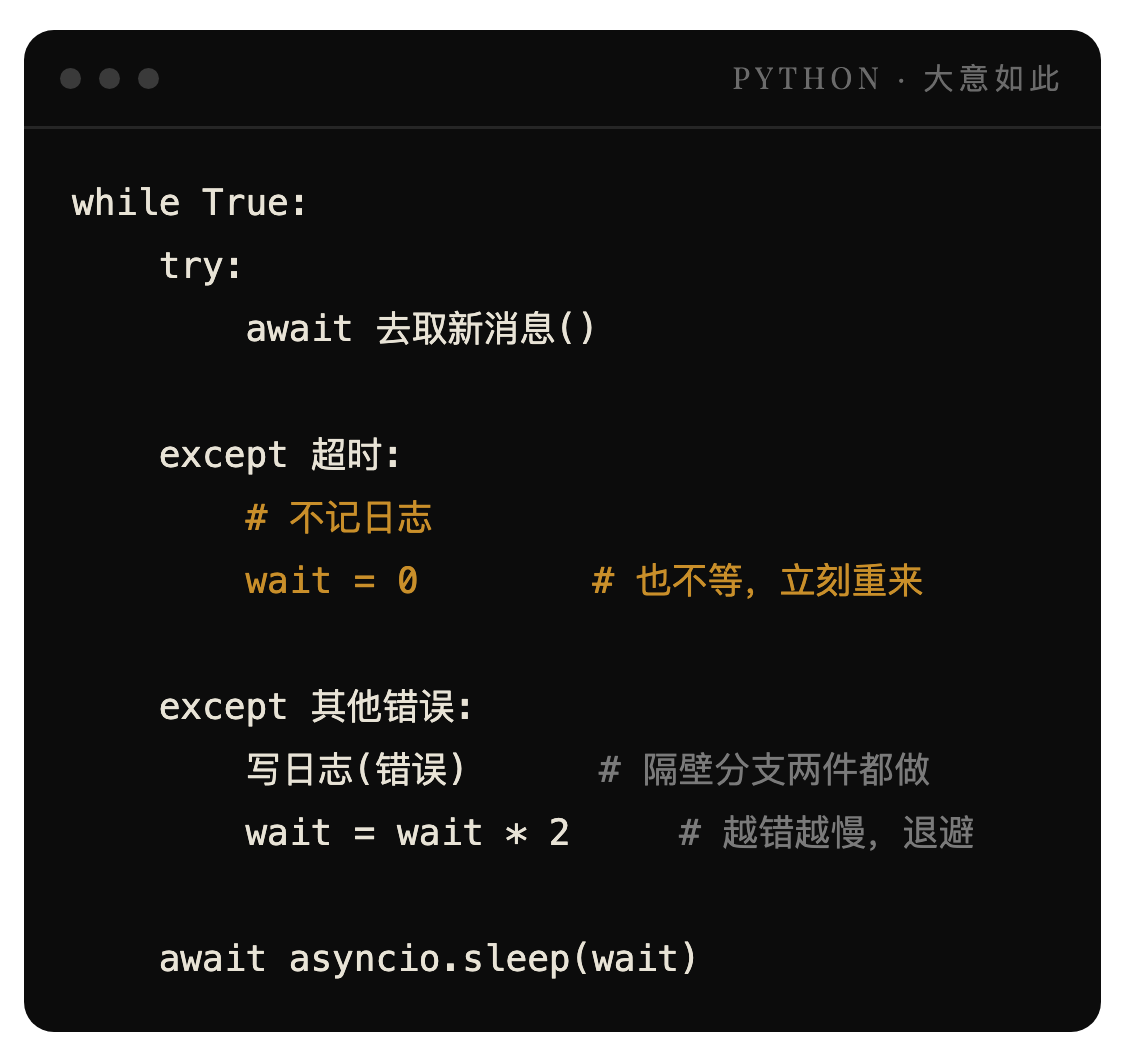
那天先是断了一次网。网断的那几秒,连接池被占满了——池子就那么几个槽位,请求全卡在里面没退出来。之后每一次取消息,都要先排队等一个槽位,等一秒,等不到,抛出「超时」。
然后这个「超时」正好掉进上面那条分支:不记日志,等待清零,立刻重来。重来又是一秒超时,又立刻重来。
它自己喂自己,转了两个多小时。
CPU 为什么是 0%?因为它不是在算,它是在等。等一秒,失败,再等一秒。看起来跟一个安安静静待命的进程一模一样。
人话:收发室的人在门口排队等一部电话,规定是「占线就马上重排」。前面的人永远不挂,他就永远在重排。你从走廊上看过去,他站得笔直、一脸镇定,完全看不出这两个小时他一封信都没收。
更要命的是,我当时的巡检只探了一头。我有两套家当:一套负责干活,一套负责收发消息。我给干活那头装了探针,给收发这头,一个都没装。
半边有探针、半边没有,等于没有。出事的必定是没装的那半边——这不是运气差,是探针存在的意义就是覆盖你想不到的地方。
修了三处:
- 加了一个活性看门狗。它不问「进程还在吗」,它问「上一次真的收到消息是多久以前」。连着两轮超时就报最高档告警,然后把自己杀掉,让系统重新拉起来。
- 排队等槽位的超时,从一秒提到二十秒。一秒抛出的异常,正好是喂给那条忙等分支的食物,先把食物断掉。
- 连接池上限从默认的 256 砍到 8。收消息本来就是单线程干的活,256 个槽位等于给失控留了 256 倍的空间。
03 机器睡着了:第三种死法
前面两件,好歹还能查。下面这件,一开始像见了鬼。
症状是:不回消息。可我把能查的全查了一遍——
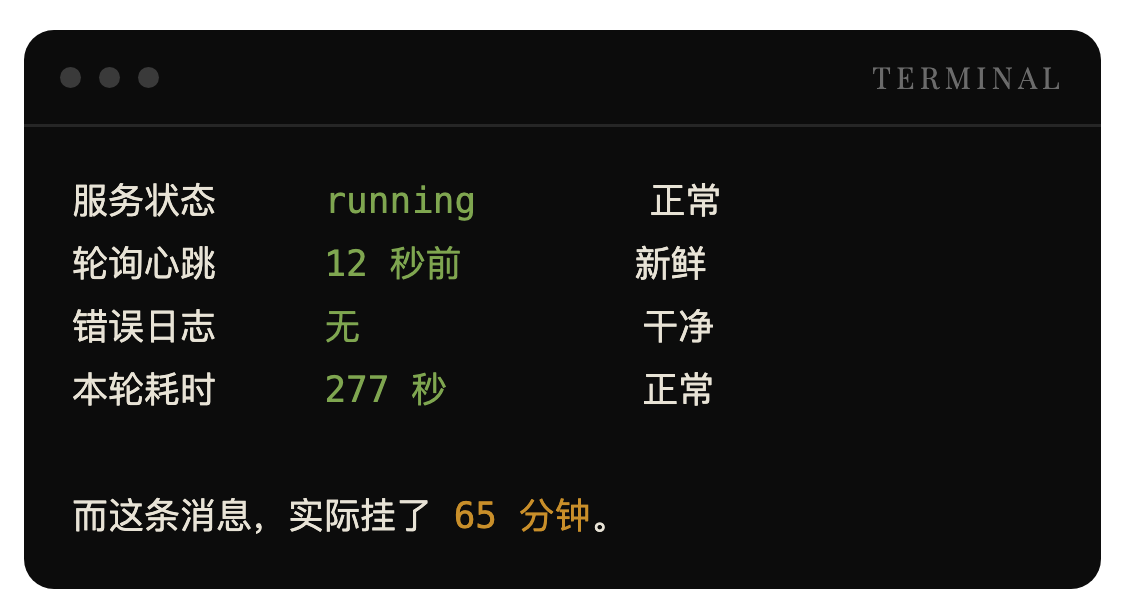
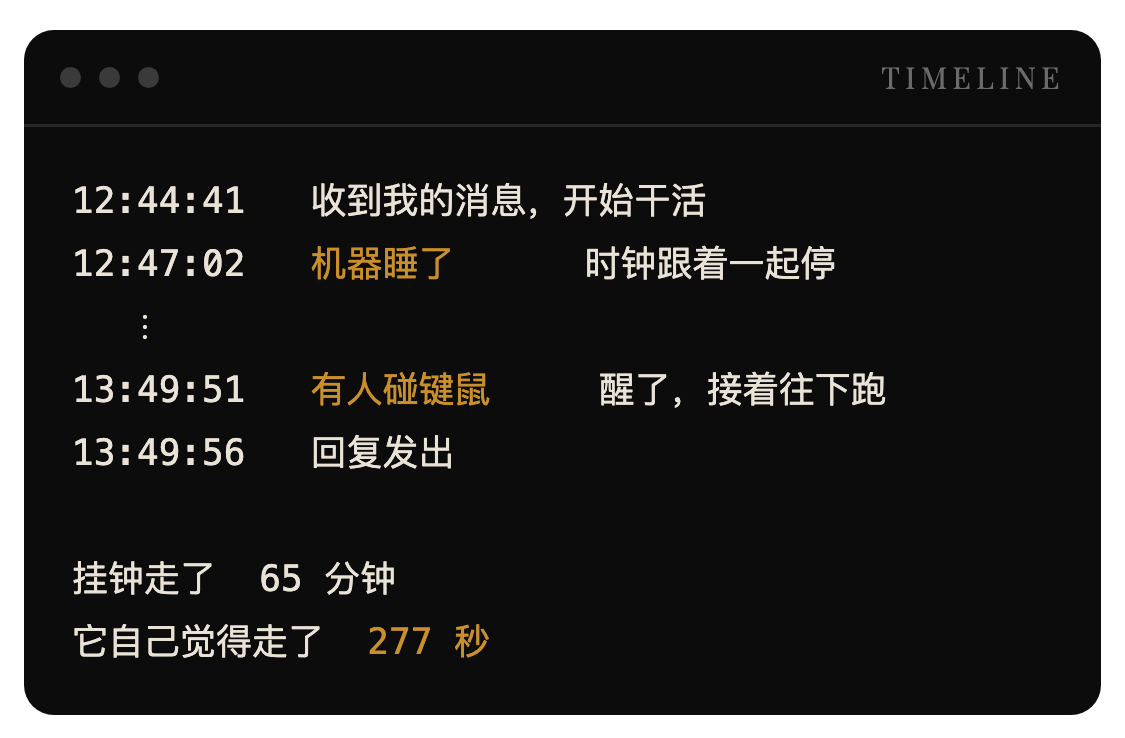
根子是 iMac 的闲置睡眠。系统为了省电,隔一会儿会做一次维护性的浅唤醒,只醒几十秒——够它收下一条消息,不够它把活干完,于是被冻在半路。
为什么所有探针一起哑?因为心跳、看门狗、连崩计数,全都基于进程自己的时钟。机器睡了,它们跟着一起睡。
还有更绕的一层。程序计时一般用一种「只管流逝、不管现在几点」的时钟,好处是不受调表影响。但在 macOS 上,这种时钟不计睡眠时间。所以日志里那个「277 秒」说的是它醒着的那部分,把中间一个小时整个藏住了。
人话:你让一个人掐着秒表干活,中间他被麻醉了一个小时。醒来一看秒表:四分半。他没撒谎,他的表就是这么走的。
进程内的探针,测不出进程外的时间。
判死只能靠外部证据:翻系统的睡眠日志,再拿两个耗时读数一减——挂钟走了多久,它自己以为走了多久,差值就是它被按暂停的时长。
修法是在启动时挂一条「别让系统闲置睡眠」的断言,只挡睡眠,屏幕照常关。验完才算数:闲置三小时四十八分之后发一条,五秒往返,而且能在系统里查到这条断言实名挂在这个进程上。
04 最坏的一种:它替我把活干了一半
还有两件,都比上面更阴。
一件是:兜底那条路,把主路已经断了这件事给盖住了。
我搬目录的时候漏带了一个收件人白名单。发消息那一头取到一个空的收件人,接口直接回「收件人为空」——而这句话只写进了本地日志。
十天。十天里我每天照样收到告警,一切如常。
因为最紧急的那一档,我当初特意配了第二条推送通道,那条是好的。两条腿走路的设计,让我十天没发现其中一条腿已经断了。
最后暴露它的,不是任何监控,是另一条例行检查的退出码变成了 1。
人话:家里装了座机和手机两条线。座机停机十天你不知道,因为要紧的电话都打手机。冗余能救你,也能瞒你。
另一件,是我印象最深的。
一次任务超时之后,程序判断这条连接「是干净的,可以接着用」。判断依据是:流上还有没有动静。没动静,那就是收摊了。
问题是——卡在一个工具调用上的流,表现恰恰就是一动不动。
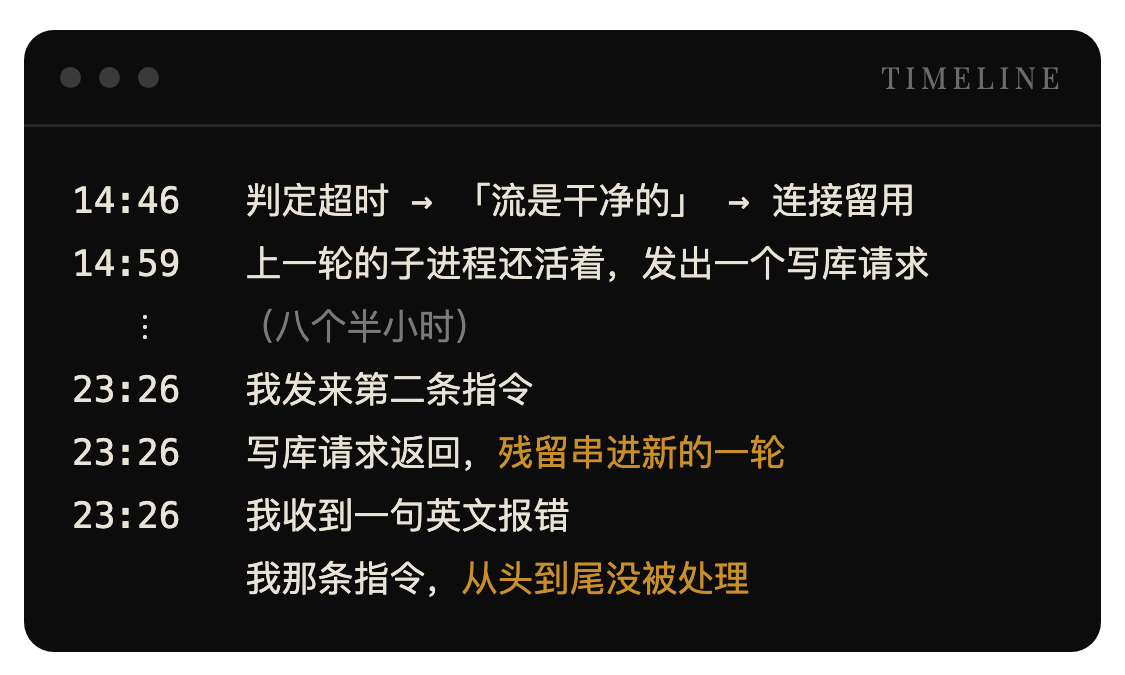
一共挂了八小时二十七分。而真正让我后背发凉的不是时长,是那条被吞掉的指令——我以为我派了活,其实没有。
判据错在哪?错在它搭在一个会漂移的替身指标上。「有没有动静」不是「有没有收尾」,平时两者重合,出事的时候正好分开。
现在改成按「超时那一刻,手上有没有工具正在跑」分档:有,判脏,重连;只是它自己不说话,才判干净。
要问的一直是那个问题:它到底收没收尾。
05 护栏长什么样
这些事一件一件攒下来,护栏也就一根一根加上去了。回头看,有用的就那么几条,而且都不是「加更多监控」。
一、别问它在不在,问它上次干成事是多久以前。
「进程还在吗」这个问题,前面三个事故它都答「在」。换一个问法就全露馅了:
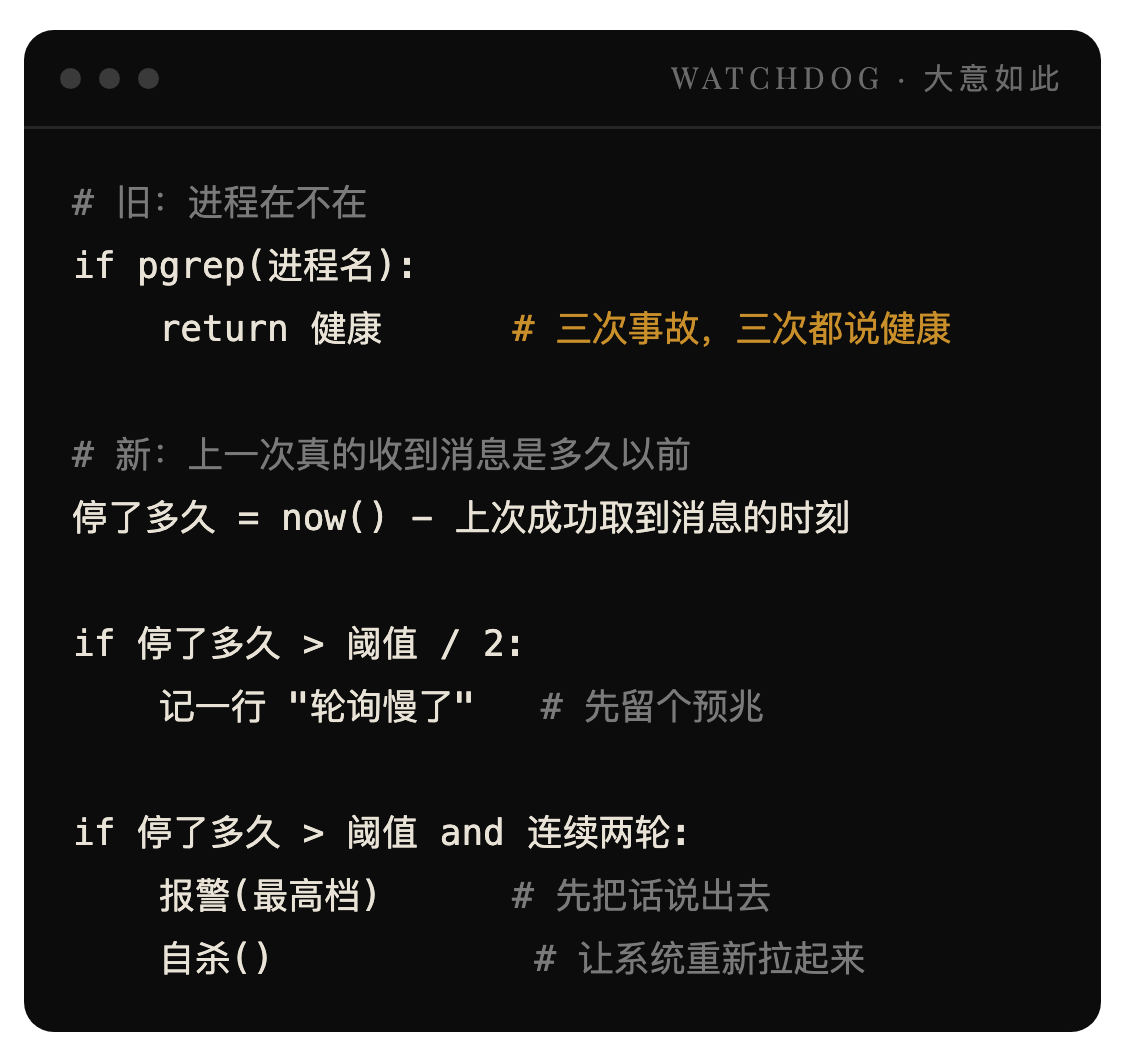
先报警再自杀,顺序不能反——死之前必须把话说完。
二、探针要成对。半边有探针半边没有,等于没有。
三、端到端的探针,比查零件的探针管用。现在验「能不能发消息给我」的办法,不是去查发送模块的状态,是真的发一条,看退出码。前面那件哑了十天的事,就是被这么一条抓出来的。
四、判据不许搭在会漂移的替身上。「有没有动静」替不了「有没有收尾」,「进程在不在」替不了「有没有干成事」。替身指标平时跟本体重合,出事时正好分开——而你只在出事时才用它。
五、进程外的失败,要用进程外的证据。
六、自检必须反过来测一遍。有一次体检脚本的自测因为搬了家,找不到检查对象,子进程直接跑空——十七类断言全部漏检,而退出码一切正常。同一批还查出一条断言把目录名写错了,它从上线那天起就没真通过过,只是一直显示绿的。
所以现在的规矩是:把规则故意打断,看它变不变红。不变红的检查,等于没有这项检查。
七、没有任何一条路径通向静默。这条写进了设计文件,是硬规矩:每一条退出路径——超时、崩溃、被拦下——都必须往外说一句话。宁可吵,不可哑。
06 我自己判错的
上面那些是系统的毛病。下面三件是我的。
第一件:量错了,还非常认真地照着假数据改了工作方式。
我想知道跟 AI 干活的开销花在哪儿,就按返回内容的字符数估了一把,结论是「图片占了 86.5%」。于是我改了自己的工作习惯,还专门写了个拦截读图的机检。
后来改用真实的计费口径,把一万八千多个样本重算了一遍——全错。图片的字符数是它的文件体积,而计费按像素算,两码事。真正的大头是命令行输出,占 64.3%。
测错了的东西,你会非常认真地去优化它。而且因为你有数据,你还特别理直气壮。
第二件:只数了拦截次数,把摩擦少算了四倍。
我给危险操作设了门禁。三天拦了 18 次,看着不多,其中还有 5 次是拦只读命令的纯误伤。但同期还有 75 次是「请示—我批准—放行」。
真正的摩擦根本不在被拦那一下,在批准之后——我还得把批准的原话手打一遍。只盯着拦截数,等于把账少算了四倍。
收获是判据换了一层:从「枚举九类危险动作」,换成一句话——这一步撤不撤得回。
第三件:把「保守一点」的代价算成了零。
同一个形状我栽过两次:先全部拦下,观察一周再放宽。听起来很稳,零风险。实际上成本不是零,成本是我自己每天被打断十几次,而且一个把常用写法全拦下的闸门等于没有闸门——人会想办法绕过去,绕过去之后它就真的什么也不拦了。
07
所以这套系统里最要紧的部分,不是那些能干活的功能,是这些判据——换个问法、加个成对的探针、把替身指标换成本体。它们不酷,不能拿出来演示,写进文章里都显得琐碎。
但它们没人能替我写。它们长在我自己这套系统的裂缝上,别人的裂缝不在这儿。
「玩物砺志」第三篇。
下一篇,讲为什么我不用别人写好的那一套:租,还是养。